Prezzi, benchmark e documentazione verificati al 24/09/2026.
Anthropic ha rilasciato Claude Opus 5.5 il 22/09/2026, con una dichiarazione netta: "Raggiunge il livello di Claude Fable 5.1 sulla maggior parte dei lavori e costa il 40% in meno rispetto a Opus 5."
I primi articoli di confronto sono usciti in poche ore. Alcuni utili, almeno uno ha dichiarato che Opus 5.5 non era ancora verificabile. Prima di scrivere questo articolo, abbiamo consultato l'annuncio ufficiale Anthropic, la pagina prezzi, la documentazione di migrazione, i primi test indipendenti e verificato ogni dato.
Ecco cosa è confermato, cosa resta solo una dichiarazione e cosa faremmo oggi alla guida di un team di sviluppo.
La sintesi
- Imposti Opus 5.5 come default per coding, agent e attività di knowledge work. La documentazione Anthropic ora indica: «Se non è sicuro su quale modello puntare, inizi da Claude Opus 5.5 per la maggior parte dei carichi.»
- Mantenga Fable 5.1 dove ha già dato risultati affidabili. Anthropic lo consiglia ancora «per ragionamento complesso, lavori agentici di lungo periodo o se le valutazioni su Claude Opus 5.5 ad effort alto non sono sufficienti.»
- Pianifichi l'abbandono di Opus 5, senza fretta. Ora è indicato come "Legacy" nella documentazione Anthropic, Opus 5.5 è più conveniente su ogni voce di costo e Anthropic dichiara che Opus 5 non verrà ritirato prima del 24/07/2027.
- Controlli il livello di effort. Il default economico (medio) e i punteggi massimi nei benchmark (max effort) non coincidono. Dettagli sotto.
- Preveda tempo per la migrazione. L'API ha cambiamenti incompatibili. Cambiare solo il nome del modello può causare errori.
Quale modello per quale attività
Se deve consultare una sola tabella, scelga questa. È la nostra raccomandazione, basata sulle indicazioni Anthropic e sui risultati indipendenti riportati sotto.
| Attività | Parta da | Effort |
|---|---|---|
| Coding quotidiano, code review, report | Opus 5.5 | Medio (default) |
| Bug complessi, refactoring su più file, integrazioni articolate | Opus 5.5 | Prima alto, poi molto alto |
| Agenti autonomi a lungo termine, ragionamento più complesso | Fable 5.1, dopo aver testato Opus 5.5 ad alto | Alto o superiore |
| Traffico Opus 5 esistente | Passare a Opus 5.5 una volta risolte le modifiche API | Impostare in modo esplicito |
| Attività semplici e ad alto volume (tagging, classificazione) | Attendere Sonnet 5.5 o Haiku 5.5 | Basso |
I tre modelli a confronto
| Opus 5.5 | Opus 5 | Fable 5.1 | |
|---|---|---|---|
| Rilasciato | 2026-09-22 | 2026-07-24 | 2026-09-01 |
| Input (per 1M token) | $4 | $5 | $10 |
| Output (per 1M token) | $20 | $25 | $50 |
| Letture cache (per 1M token) | $0.20 | $0.50 | $0.25 |
| Finestra di contesto | 1M | 1M | 1M |
| Output massimo | 128K | 128K | 128K |
| Sforzo predefinito | medium | high | high |
Rispetto a Opus 5, i prezzi di input e output di Opus 5.5 sono inferiori del 20% e le letture cache del 60%. Rispetto a Fable 5.1, input e output sono inferiori del 60%. In altre parole, Fable costa 2,5 volte tanto.
Cosa significa davvero "40% in meno"
Il taglio del prezzo di listino è solo del 20%. Anthropic attribuisce il resto all'efficienza: Opus 5.5 «costa meno per token rispetto a Opus 5 e utilizza meno token per task, portando a una riduzione complessiva del 40% dei costi.»
Un dettaglio è rilevante. Anthropic ha calcolato quel 40% «con le impostazioni predefinite». Per Opus 5.5 il predefinito è sforzo medio, mentre per Opus 5 era alto. Se si esegue Opus 5.5 con sforzo alto o massimo, il risparmio sarà inferiore.
Per rendere concreti i prezzi, abbiamo preso il task di esempio dall'analisi dei costi di Anthropic e lo abbiamo calcolato su ciascun modello. Il task prevede 40 turni, circa 2,8 milioni di token in input (90% letti dalla cache) e 60.000 token in output.
| Modello | Input cost | Output cost | Total |
|---|---|---|---|
| Opus 5.5 | $1.62 | $1.20 | $2.82 |
| Opus 5 | $2.66 | $1.50 | $4.16 |
| Fable 5.1 | $3.43 | $3.00 | $6.43 |
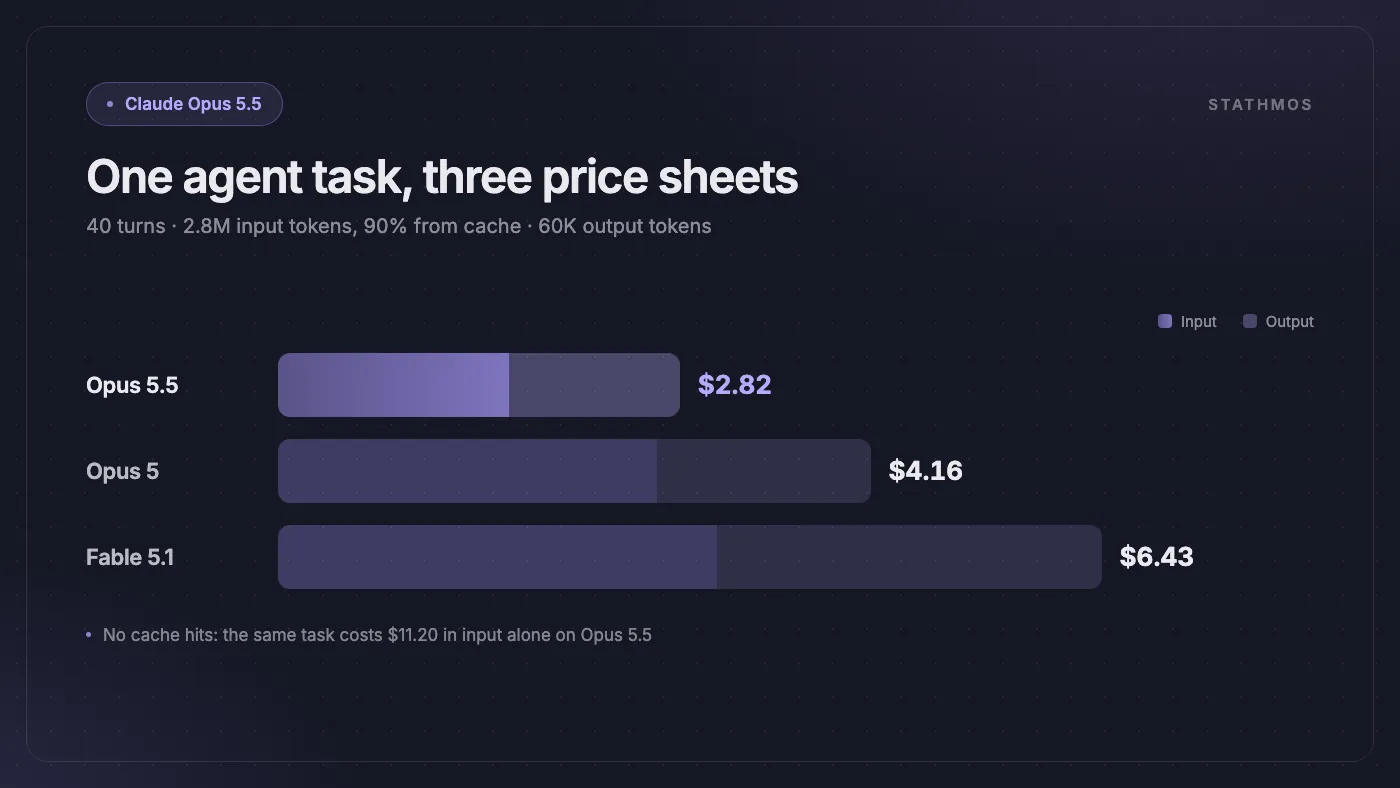
Due avvertenze. Come nell'esempio di Anthropic, la tabella non include i costi di scrittura in cache. Inoltre, si assume che ogni modello utilizzi lo stesso numero di token, cosa che non avviene nell'uso reale. Si consideri come indicazione di massima, non come preventivo.
La cache incide più della scelta del modello. Lo stesso task senza cache costa $11,20 solo di input su Opus 5.5, quattro volte il costo totale con cache attiva. Se la fattura AI sembra elevata, verifichi il tasso di hit della cache prima di cambiare modello. Approfondiamo il resto dei costi in quanto costa davvero l'AI a un e-commerce.
Risultati sui benchmark di Anthropic
Questi sono i dati pubblicati da Anthropic:
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Agentic coding: Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% |
| Agentic coding: FrontierCode v1.1 | 54.4% | 50.3% | 48.0% |
| Agentic coding: CursorBench 4.0 | 57.8% | 51.8% | 46.6% |
| Lavoro intellettuale: GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 |
| Computer use: OSWorld 2.0 (parziale) | 81.8% | 80.7% | 74.0% |
| Reasoning: Humanity's Last Exam (con strumenti) | 67.7% | 65.6% | 63.6% |
Opus 5.5 guida ogni riga in questa tabella. Quattro aspetti da considerare:
- Questi punteggi riflettono le impostazioni di massimo sforzo. Anthropic ha eseguito Opus 5.5 quasi sempre al massimo sforzo e a xhigh per Terminal-Bench 4.0. Non è il valore predefinito medio che la maggior parte dei team utilizza. Va detto che Anthropic riporta anche che, con sforzo medio, Opus 5.5 ha ottenuto il 54,6% su FrontierCode, superando tutti gli altri modelli.
- Anthropic ridimensiona i propri margini. Sostiene che i gap nei benchmark «sono diventati meno affidabili come indicatore delle differenze nel mondo reale». Aggiunge inoltre che, nei propri test interni, «la differenza tra Opus 5.5 e Claude Fable 5.1 è più ridotta di quanto suggeriscano questi punteggi».
- Non vince ovunque. Nel grafico di Anthropic, GPT-6 Astra di OpenAI ottiene un punteggio superiore su AutomationBench (41,4% contro 40,0%) e Terminal-Bench-Science (64,6% contro 58,7%).
- È difficile da testare. Nell'annuncio, Anthropic afferma: «Abbiamo riscontri che Opus 5.5 spesso sospetta di essere valutato». Un motivo in più per provarlo sul proprio lavoro reale.
Cosa mostrano i test indipendenti
Artificial Analysis, società indipendente di benchmarking, ha già testato Opus 5.5 sul proprio Intelligence Index. Ecco i risultati disponibili al momento:
| Modello e livello di sforzo | Intelligence Index | Cost per task |
|---|---|---|
| Opus 5.5 (max) | 58 | $5.98 |
| Opus 5.5 (xhigh) | 56 | |
| Opus 5.5 (high) | 54 | |
| Fable 5.1 (max) | 53 | $7.63 |
| Opus 5.5 (medium, predefinito) | 51 | $1.34 |
| Opus 5 (max) | 51 | $5.86 |
Il costo per task è la media ponderata di Artificial Analysis per ciascun task dell'Intelligence Index; non riportato dove non pubblicato per quella configurazione.
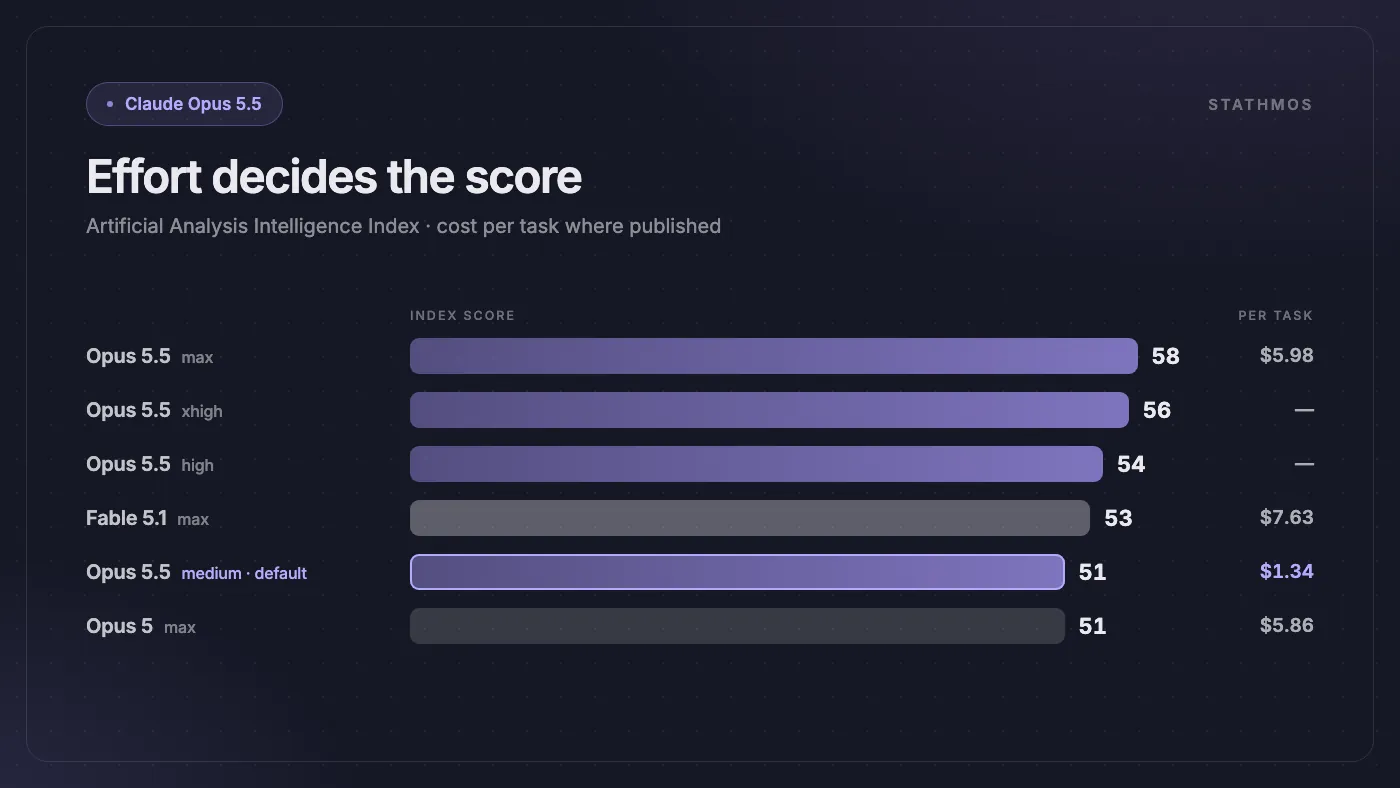
Con sforzo massimo, Opus 5.5 ottiene il punteggio più alto nell'indice e costa meno di Fable 5.1: $5,98 per task contro $7,63 di Fable.
Il dato più utile è più in basso. Con impostazione media predefinita, Opus 5.5 ha ottenuto 51. È lo stesso punteggio di Opus 5 a massimo sforzo, ma inferiore a Fable 5.1. Supera Fable solo con sforzo high o superiore. Il livello medio costa molto meno, $1,34 per task, e per molte attività quotidiane può bastare. Ma se serve la qualità di Fable su problemi complessi, occorre aumentare lo sforzo e accettare il costo.
Come si comporta su casi reali
L'esempio più concreto fornito da Anthropic è un test interno: ha chiesto a Opus 5.5 e Fable 5.1 di riscrivere HAProxy, un load balancer molto diffuso, da C a Rust. Entrambe le versioni hanno superato quasi tutti i test di regressione di HAProxy. Opus 5.5 ha completato il lavoro in 9,5 ore, contro le 12 di Fable 5.1, con un costo inferiore del 51%. È un solo task, gestito da Anthropic, ma si tratta di un'attività ingegneristica reale, non di un esercizio teorico.
Anthropic ha pubblicato anche i primi feedback dei clienti. GitHub ha dichiarato che in VS Code, Opus 5.5 «ha risolto più task da terminale di Opus 5 in meno della metà dei passaggi». Optiver ha riferito che, sulle proprie attività di coding agentico, «ha raggiunto la qualità di Opus 5 in circa metà dei turni, del tempo e dei token generati, riducendo il costo di quel carico di lavoro del 40-50%». Si tratta di prime impressioni, non di audit.
Altri due cambiamenti sono rilevanti:
- Velocità. Anthropic afferma che Opus 5.5 «genera output oltre il 30% più rapidamente di Opus 5». Esiste anche una modalità rapida, ancora in anteprima di ricerca, che promette fino a 2,5 volte la velocità a $8 input e $40 output per milione di token. Funziona in Claude Code e su Claude API, ma non su AWS, Google Cloud o Microsoft Foundry.
- Scrittura. Secondo Anthropic, il modello «porta le informazioni più importanti all'inizio» ed è «meno incline a usare gergo». Questo è utile per report, passaggi di consegne e comunicazioni verso il cliente.
Prima di cambiare: le criticità
Questa è la sezione che la maggior parte dei confronti omette. Dal migration guide di Anthropic:
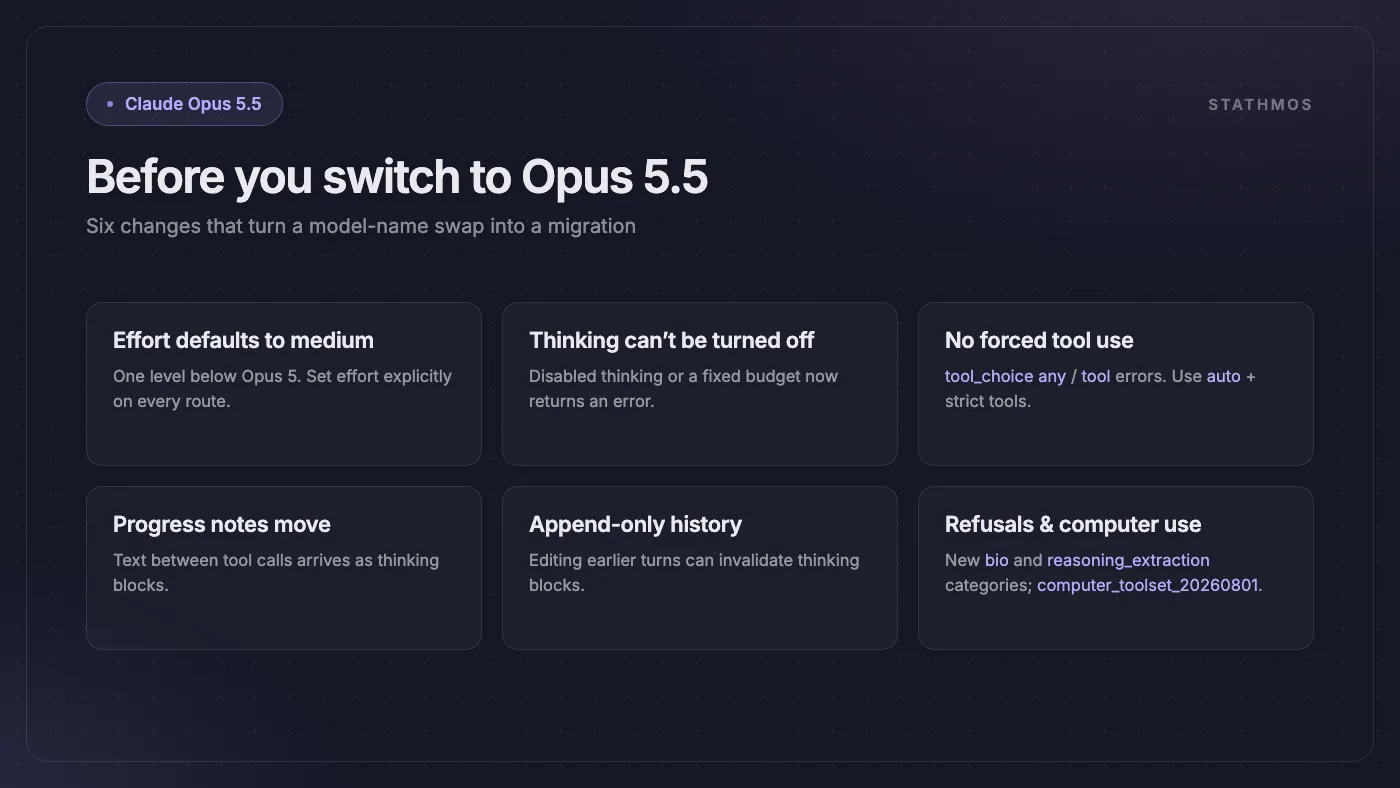
- Lo sforzo predefinito ora è medium, non high. Se non si imposta mai lo sforzo, si otterrà meno thinking rispetto al passato. Costa meno, ma è opportuno verificare la qualità sui task più complessi e impostare lo sforzo in modo esplicito.
- Thinking non può essere disattivato. Le richieste che disabilitano thinking o impostano un budget fisso ora restituiscono errore. Utilizzare invece il parametro
effort(da low a max). - Forced tool use non è più disponibile.
tool_choiceimpostato suanyo su uno specifico ora restituisce errore. Usareautoper l'uso rigoroso degli strumenti o per output strutturati. - La sua UI potrebbe diventare silenziosa. Le brevi progress notes che il modello scrive tra una chiamata tool e l'altra ora arrivano come thinking block, non come testo. Se queste note vengono mostrate agli utenti, spariranno a meno di modificare la visualizzazione.
- Lasciare spazio in max_tokens. Thinking viene eseguito a ogni richiesta e
max_tokenscopre sia thinking che risposta. Con effort xhigh o max, Anthropic suggerisce di partire da 64K. - Mantenere le conversazioni solo in append. Modificare system prompt, strumenti o messaggi precedenti durante la conversazione può invalidare i thinking block. Per gli account creati dal 31/08/2026, questo restituisce errore di default.
- Nuove categorie di refusal. Il codice deve gestire
stop_reason: "refusal", incluse nuove categorie comebioereasoning_extraction. - Computer use ha un nuovo tool. Su Claude API e Google Cloud, il vecchio tool per computer-use è sostituito da
computer_toolset_20260801. Su Amazon Bedrock, il tool precedente è ancora disponibile.
Nessuna di queste modifiche è complessa, ma si tratta di una vera migrazione, non di una semplice sostituzione del nome.
Cosa continuiamo a monitorare
- Impostazioni predefinite vs punteggi massimi. Il grafico di lancio mostra il massimo sforzo. La fattura probabilmente rifletterà il livello medio. È importante sapere quale impostazione si sta utilizzando.
- Fable 5.1 ha ancora un ruolo. Anthropic lo consiglia per i casi più complessi e le attività di lunga durata. Non lo abbandoni senza averlo testato.
- I risparmi dipendono dalla configurazione. Una cattiva gestione della cache può incidere più della scelta del modello.
- Stanno arrivando modelli più piccoli. Anthropic prevede il rilascio di Sonnet 5.5 e Haiku 5.5 «nelle prossime settimane». Per attività semplici e ad alto volume, può valere la pena attendere.
Come procedere al rollout
- Selezioni da 10 a 20 attività reali dal suo backlog: una correzione di bug, una code review, un aggiornamento di plugin, uno script di importazione dati, un report. Per i team e-commerce, sono test utili le attività già note, come un bug nel checkout o un'importazione di catalogo prodotti.
- Esegua questi task sia sul modello attuale sia su Opus 5.5 con un livello di impegno medio. Confronti qualità, tempi e costo per attività.
- Se la qualità cala, provi con un livello di impegno alto prima di tornare a Fable. È anche quanto suggeriscono le guide di Anthropic.
- Applichi prima le modifiche API sopra indicate in un ambiente di sviluppo. La guida di Anthropic raccomanda di «testare in ambiente di sviluppo prima di spostare il traffico in produzione».
- Porti il traffico predefinito sul nuovo modello e mantenga Fable 5.1 come fallback per i casi più complessi.
Misuri il costo per attività completata, non per singola richiesta. Una richiesta meno costosa che richiede più iterazioni non è davvero più economica. È la stessa lezione vista analizzando il vero ROI dello sviluppo web agentico: il modello raramente è il collo di bottiglia; conta come si testa e si revisiona il suo lavoro.
In sintesi
Per la maggior parte dei team, Opus 5.5 sembra il nuovo standard: prezzi più bassi, output più rapido e ottimi risultati nei test indipendenti a massimo impegno. Tuttavia, non dia per scontato che le impostazioni di default offrano risultati pari a Fable sui problemi più complessi. Testi con i suoi task reali, scelga il livello di impegno che regge e si lasci guidare dai dati, non dai grafici di lancio.
Domande frequenti
Opus 5.5 è migliore di Fable 5.1?
Sui benchmark Anthropic con effort massimo, sì; anche Artificial Analysis posiziona Opus 5.5 sopra Fable 5.1 al massimo effort. Con effort medio (default) invece Opus 5.5 resta sotto Fable 5.1, quindi per i compiti più complessi serve effort alto o superiore. Anthropic consiglia ancora Fable 5.1 per lavori agentici complessi e di lunga durata.
Quanto costa meno Opus 5.5 rispetto a Opus 5 e Fable 5.1?
Opus 5.5 costa $4 in input e $20 in output per milione di token: il 20% in meno rispetto a Opus 5 e il 60% in meno rispetto a Fable 5.1. Le letture da cache costano $0,20, contro $0,50 su Opus 5. Il risparmio del 40% dichiarato da Anthropic su Opus 5 considera anche meno token per task e si riferisce alle impostazioni di default.
Qual è l'effort di default su Opus 5.5?
Medio, un livello sotto rispetto all'alto di default su Opus 5 e Fable 5.1. Conviene impostare l'effort in modo esplicito e aumentarlo ad alto o xhigh per coding complesso e lavori agentici.
Posso cambiare solo il nome del modello per passare a Opus 5.5?
Non in sicurezza. La funzione thinking non si può disattivare, l'uso forzato degli strumenti genera errore, le note di avanzamento passano nei blocchi thinking, le conversazioni devono essere solo in append, e l'uso computer richiede un nuovo tool su Claude API e Google Cloud. Gestisca questi aspetti prima in ambiente di sviluppo.
Devo smettere di usare Opus 5?
Conviene pianificare la migrazione, ma senza urgenza. Opus 5 è ora indicato come Legacy e Anthropic dichiara che non verrà ritirato prima del 24/07/2027. Poiché Opus 5.5 è più conveniente su ogni voce di costo, la maggior parte dei team dovrebbe passare una volta gestite le modifiche API.
Fonti
- Anthropic: Introducing Claude Opus 5.5
- Anthropic: Introducing Claude Fable 5.1 and Claude Mythos 5.1
- Claude Docs: Models overview
- Claude Docs: Pricing
- Claude Docs: Claude Opus 5 (legacy)
- Claude Docs: What's new in Claude Opus 5.5
- Claude Docs: Migrating to Claude Opus 5.5
- Claude Blog: What a task costs on Opus 5.5
- Artificial Analysis: Claude Opus 5.5 results
- Artificial Analysis: Claude Fable 5.1
- Artificial Analysis: Claude Opus 5
- TechCrunch: Anthropic releases Opus 5.5
Sta valutando il passaggio a Opus 5.5?
Progettiamo e gestiamo sistemi AI e ML per team commerce, e possiamo eseguire il test comparativo sopra descritto sui suoi task: backlog, prompt, costo per attività completata. Se desidera supporto per la migrazione o il test, ci contatti.